Come facciamo lavorare più agenti di programmazione su un solo repository con i git worktree
Quasi ogni giorno, più agenti di programmazione lavorano contemporaneamente nel nostro repository. Uno costruisce una funzionalità, un altro rivede un branch diverso, un terzo corregge un test che fallisce. Una copia di lavoro normale contiene un branch alla volta, e cambiare branch sotto un agente a metà di una build ne rovina il lavoro. I git worktree risolvono il problema: ogni agente riceve una propria cartella con un proprio branch, e tutte le cartelle condividono un solo repository.
Questo articolo spiega che cosa un worktree condivide e che cosa tiene per sé, i comandi che usiamo ogni giorno, come assegniamo i worktree agli agenti e le quattro trappole che lo stato condiviso ci ha teso, con la regola che ha eliminato ciascuna.
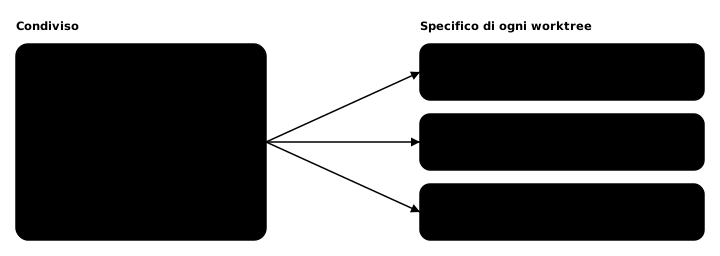
Che cos’è un worktree
Un worktree è una cartella con un commit selezionato che appartiene a un repository esistente. La cartella creata da git clone o git init è il worktree principale; git worktree add crea accanto ad essa dei worktree collegati. Un worktree collegato condivide tutto con il repository, tranne alcuni file propri: il suo HEAD, il suo indice e i file su disco.
In pratica:
- Condiviso: ogni oggetto, ogni riferimento sotto
refs/(branch, tag, branch di tracciamento remoto e lo stash, che è il riferimentorefs/stash), il file di configurazione e gli hook. - Per worktree: HEAD, l’indice, i file selezionati e alcuni riferimenti che git tiene separati di proposito (
refs/bisect,refs/worktree,refs/rewritten). - Un branch, un worktree: git rifiuta di selezionare un branch che un altro worktree ha già, a meno che non sia forzato. Un commit può essere selezionato in tutti i worktree che si desidera con un HEAD staccato.
Quindi un commit creato in un worktree è subito visibile in tutti gli altri, senza un fetch. Un branch creato in uno è presente in tutti. Questo rende i worktree economici: non si copia nient’altro che i file su cui si lavora.
I comandi che usiamo
git worktree add -b 123-export-csv ../work/123-export-csv origin/master
git worktree add --detach ../work/review-123 <commit>
git worktree list
git worktree remove ../work/123-export-csv
git worktree prune
La prima riga crea un nuovo branch a partire dall’ultimo branch principale remoto e lo seleziona in una nuova cartella. La seconda seleziona un commit senza branch, per una revisione o un’esecuzione di test che non deve spostare nulla. list mostra ogni worktree con il suo commit e il suo branch. remove elimina la cartella e le registrazioni di git che la riguardano, e rifiuta di procedere finché la cartella contiene modifiche o file non tracciati, o contiene sottomoduli; --force supera questo blocco. prune cancella le registrazioni di git relative ai worktree le cui cartelle sono state eliminate a mano.
Come assegniamo i worktree agli agenti
Ogni compito riceve un worktree, creato dall’agente che svolgerà il lavoro:
- Un compito, un worktree, un branch. Il branch prende il nome dall’issue del compito e il worktree parte dall’ultimo branch principale remoto, così ogni agente comincia dallo stesso punto, qualunque cosa sia selezionata altrove.
- Dentro il progetto, in una cartella ignorata da git. I worktree vivono in una cartella della copia di lavoro principale che git ignora, così i loro file e i loro log sono a un clic di distanza nell’editor e non compaiono mai come modifiche nella copia di lavoro principale.
- Un revisore riceve un proprio worktree staccato sull’esatto commit in revisione. L’autore può continuare a lavorare sul branch mentre la revisione procede, e la revisione legge un commit che non può spostarsi sotto di essa.
- Percorsi assoluti, non
cd. Un agente può eseguire più comandi di shell in parallelo in una sola sessione, ed essi condividono un’unica cartella di lavoro: uncdin uno sposta gli altri. I nostri agenti scrivono ogni percorso per intero oppure usanogit -C <folder>, così ogni comando agisce sul worktree a cui è destinato. - Rebase prima di ogni push. Il branch viene riallineato con rebase sull’ultimo branch principale remoto prima di ogni push e compresso in un solo commit prima che si apra la sua pull request, così un merge aggiunge alla cronologia esattamente un commit.
- Pulizia dopo il merge. Quando la modifica è stata unita e verificata, l’agente rimuove il worktree, elimina il branch in locale e sul remoto, esegue
git worktree prunee controlla che nessuno dei due risulti ancora elencato.
Quattro trappole e la regola che ha eliminato ciascuna
Tutto ciò che un worktree condivide è condiviso con ogni agente nello stesso momento. Ciascuna delle trappole seguenti ci è costata un’esecuzione rovinata prima che la trovassimo.
Lo stash è un’unica pila per tutti
git stash inserisce nel riferimento refs/stash, e quel riferimento è condiviso. Un agente ha messo da parte il proprio lavoro in corso; un altro agente, in un worktree diverso, ha eseguito git stash pop e ha preso quella voce. Le modifiche del primo agente sono sparite dalla sua cartella e sono tornate soltanto tramite git fsck --unreachable.
La regola: gli agenti non usano mai git stash. Il lavoro non terminato viene parcheggiato come commit sul branch dell’agente stesso, che nessun altro worktree può prendere.
Anche la configurazione è condivisa
Le impostazioni dei sottomoduli vivono nella configurazione del repository, che ogni worktree condivide. Un agente che ha eseguito git submodule deinit mentre rimuoveva il proprio worktree ha annullato la registrazione del sottomodulo per la copia di lavoro principale e per ogni altro worktree, e la build è fallita in tutti.
Le regole: un worktree con sottomoduli si rimuove soltanto con git worktree remove --force, mai dopo un deinit; e un worktree nuovo esegue git submodule update --init prima della prima build, perché un worktree nuovo parte con le cartelle dei sottomoduli vuote.
Le dipendenze non vanno condivise tramite un collegamento simbolico
Installare le dipendenze in ogni nuovo worktree richiede tempo, e un collegamento simbolico al node_modules di un’altra copia di lavoro sembra una scorciatoia. Non lo è: npm installa attraverso il collegamento e rimuove i pacchetti che non si aspetta, dalla copia di lavoro a cui il collegamento punta, e ha interrotto a metà l’esecuzione dei test di un altro agente.
Le regole: ogni worktree installa le proprie dipendenze. Quando una copia fa risparmiare tempo, cloniamo la cartella con copy-on-write (cp -Rc su APFS di macOS, che condivide i blocchi del disco finché un file non cambia) e svuotiamo qualsiasi cache che memorizzi percorsi assoluti, come la cache di trasformazione di Playwright, perché punterebbe ancora all’altra copia di lavoro.
Strumenti che registrano la cartella in cui sono stati eseguiti
Alcuni strumenti scrivono nel proprio output il percorso da cui sono stati eseguiti. I nostri piani di infrastruttura, eseguiti da un worktree, mostravano modifiche che erano soltanto quel percorso, non modifiche reali di qualcosa.
La regola: le modifiche all’infrastruttura vengono applicate soltanto dalla copia di lavoro principale, dopo che la modifica è stata unita, mai da un worktree; un piano eseguito in un worktree serve soltanto per essere letto.
Quanto costa
I worktree sono economici in cronologia, non in disco o CPU. Ciascuno contiene un insieme completo di file selezionati e, per una web app, le proprie dipendenze, perciò una dozzina di worktree occupa spazio reale. Le build condividono gli stessi processori, perciò eseguiamo una sola build pesante alla volta. E un worktree che non viene mai rimosso tiene il proprio branch selezionato e lo blocca altrove, motivo per cui la pulizia fa parte del compito e non è un ripensamento.
Domande frequenti
Che cosa condivide un git worktree con la copia di lavoro principale?
Quasi tutto. Gli oggetti, i branch e i tag, lo stash e la configurazione sono condivisi. Ogni worktree ha il proprio HEAD, il proprio indice e i propri file su disco, perciò in ogni cartella può essere selezionato contemporaneamente un branch diverso.
Due worktree possono avere selezionato lo stesso branch?
No. Git rifiuta di selezionare un branch che un altro worktree ha già selezionato, a meno che non lo si forzi. Un worktree può invece selezionare un commit con un HEAD staccato, ed è così che diamo a un revisore l’esatto commit in revisione.
Perché gli agenti non devono usare git stash in un worktree?
Lo stash è un unico riferimento, refs/stash, condiviso da tutti i worktree del repository. Un agente che estrae lo stash può prendere la voce di un altro agente. Parcheggiamo invece il lavoro non terminato come commit sul branch dell’agente stesso.
Come si pulisce un worktree dopo un merge?
Lo si rimuove con git worktree remove, si elimina il branch in locale e sul remoto, si esegue git worktree prune e si controlla che né il branch né il worktree risultino ancora elencati.